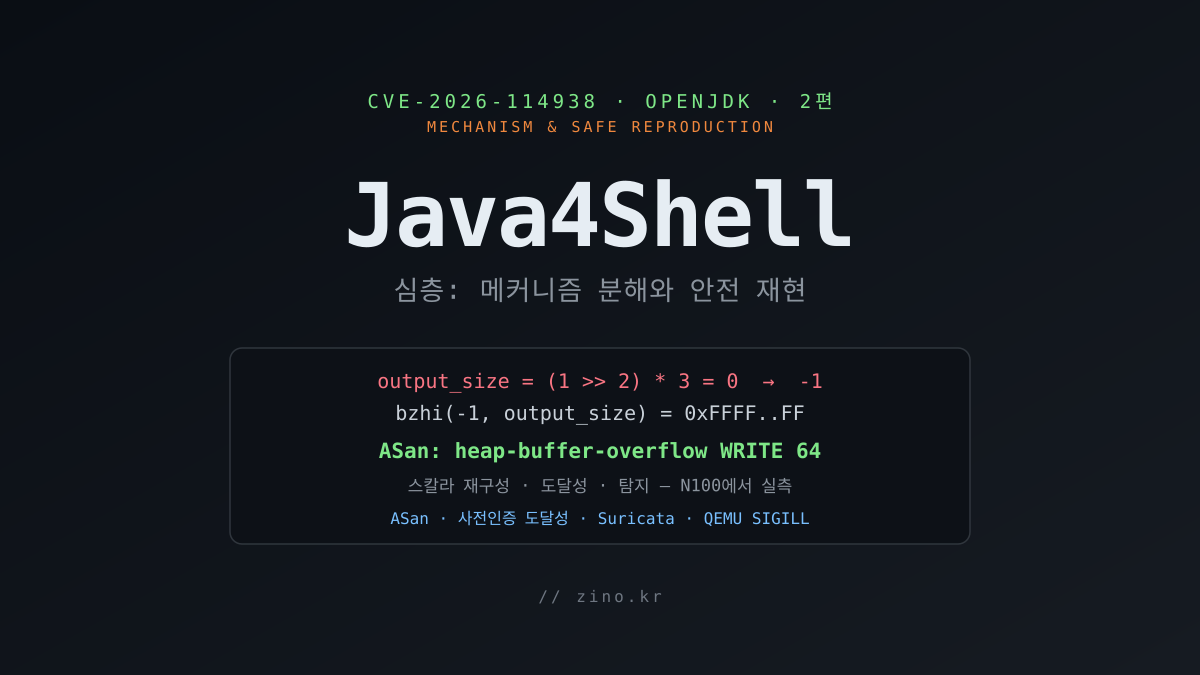
1편에 이어 — 이번엔 "되는 것만" 진짜로 재현한다
1편에서 Java4Shell(CVE-2026-114938) 의 근본 원인을 OpenJDK 소스로 교차검증했다. HotSpot의 AVX-512 VBMI Base64 디코드 인트린식이 패딩된 꼬리를 처리할 때 output_size가 언더플로해, 저장 마스크가 전부 1이 되고 64바이트를 힙 밖으로 쏟는다는 것이었다. 다만 1편은 명확히 분석글이었다 — 분석 랩 CPU(Intel N100)에 취약한 벡터 경로 자체가 없어 크래시를 낼 수 없었기 때문이다.
이번 2편은 그 한계 안에서 우리 하드웨어로 되는 진짜 캡쳐만 모았다. 핵심은 한 문장이다 — 벡터 명령을 실행하지 않고도, OOB를 만드는 정수 연산 자체는 똑같이 재현할 수 있다. 그걸 AddressSanitizer로 잡고, 공격 표면 도달성을 실측하고, 공개 PoC의 무기화 전략을 코드로 해부하고, 패치와 탐지를 실제로 돌린다.
jdk/17.0.6/bin/java -version; echo '--- host CPU ---'; lscpu | grep 'Model name'; echo -n 'avx512/bmi2 flags: '; grep -oE 'avx512vbmi|avx512f|bmi2' /proc/cpuinfo | sort -u | paste -sd' '; echo '--- toolchain ---'; cc --version | head -1; suricata -V; qemu-x86_64 --version | head -1
랩은 Intel N100이다. /proc/cpuinfo에 avx512vbmi도 avx512f도 없고 bmi2만 있다. 그래서 1편과 똑같이, 이 CPU에서는 취약한 벡터 스텁이 컴파일조차 되지 않는다. 하지만 bmi2가 있다는 건 중요하다 — 버그의 핵심인 BZHI 명령을 진짜로 실행할 수 있다는 뜻이다. 이 글의 중심 재현이 여기서 출발한다.
무엇을 재현했고, 무엇은 못 했나 — 먼저 정직하게
과장 없이 범위부터 가른다. 아래가 이 글이 실제로 실측한 것과 못 한 것이다.
| 항목 | 상태 | 증거 |
|---|---|---|
| OOB를 만드는 정수 산술 + 힙 오버플로 | 재현함 | ASan heap-buffer-overflow WRITE 64 (N100) |
인증 전 java.util.Base64 decode 도달성 | 재현함 | 로컬 HTTP 서버 + 소켓 요청 → decode0 스택 |
| 탐지(IDS 경보) | 재현함 | Suricata가 트리거 pcap에 경보 발화 |
| 패치 대조(취약↔픽스 가드) | 재현함 | 픽스 커밋 5177a70b git diff |
| 공개 PoC 무기화 전략 | 코드 리딩만 | 실행 아님 — 소스 해부 |
| 벡터 경로 실발화(진짜 62바이트 OOB) | 못 함 | 네이티브 AVX-512 VBMI CPU 필요 |
| pre-auth RCE | 우리가 아닌 Calif.io·공개 PoC의 주장 | 레포에 무기화 셸 없음 |

Source: Calif.io — Java4Shell
즉 "RCE"는 끝까지 Calif.io와 공개 PoC(ikow)의 주장이고, 우리 기여는 그 아래 깔린 메커니즘과 안전 재현이다. 이 구분을 글 끝까지 흐리지 않는다.
취약 스텁의 산술을 다시 읽는다
중심 재현을 이해하려면 꼬리 처리 어셈블리를 한 번 더 봐야 한다. 1편이 분석한 바로 그 jdk-17.0.6-ga 태그에서, L_finalBit 구간을 뽑는다.
git -C jdk17u-src show jdk-17.0.6-ga:src/hotspot/cpu/x86/stubGenerator_x86_64.cpp | sed -n -e '6204,6227p'
핵심 네 줄만 추리면 이렇다.
movl(output_size, length)·shrl(output_size, 2)·lea(...)→output_size = (length / 4) * 3- 꼬리가
=로 끝나면L_padding으로 가서decrementq(output_size, 1) L_donePadding에서movq(output_mask, -1)·bzhiq(output_mask, output_mask, output_size)- 그 마스크로
evmovdqub가 최대 64바이트를 저장
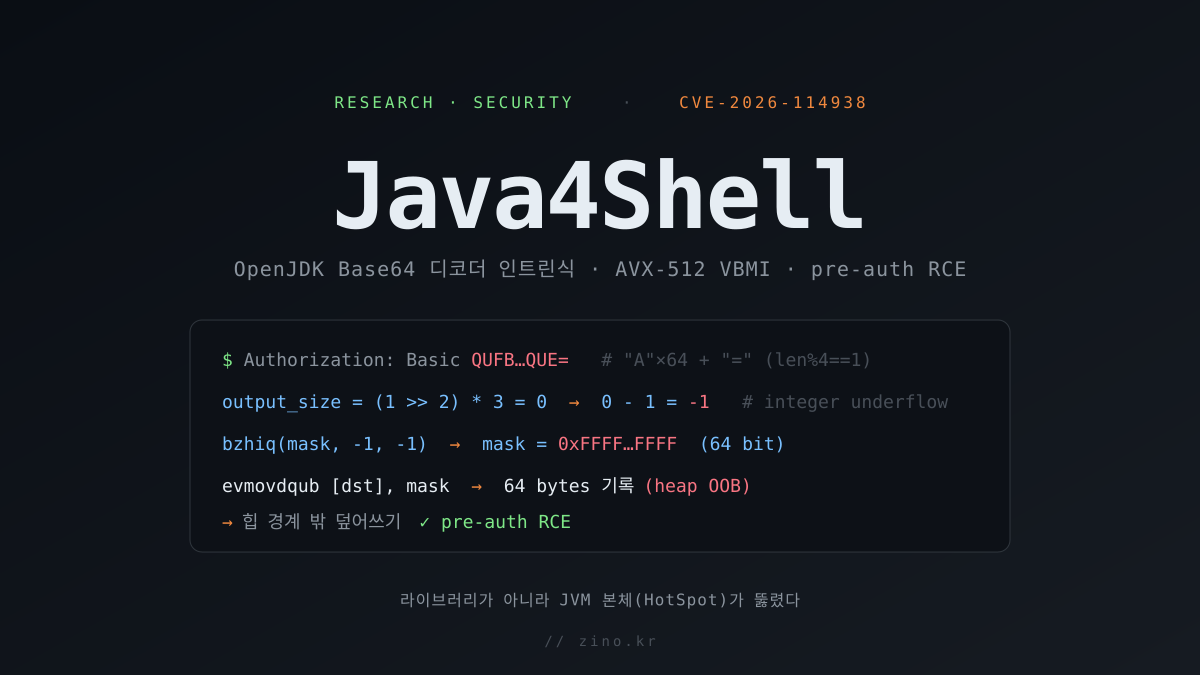
트리거 "A"×64 + "="에서 블록 루프가 64개 A를 소비하고 꼬리에 = 한 글자(길이 1)만 남는다. 그러면 output_size = (1 >> 2) * 3 = 0, 패딩 =로 1 깎여 -1, bzhi의 인덱스 하위 바이트가 0xFF = 255 ≥ 64라 아무 비트도 안 지워져 마스크가 전부 1 → 64바이트 저장. 이 정수 연산 사슬에는 벡터 명령이 필요 없다. shr, lea, dec, bzhi — 전부 N100이 실행한다.
중심 재현 — 스텁 산술을 그대로 옮긴 스칼라 모델 + ASan
그래서 벡터 경로를 흉내 내지 않고, 위 정수 연산만 1:1로 C로 옮겼다. 벡터 저장(evmovdqub)은 "마스크 비트 수만큼 memcpy"로 치환한다 — 마스크가 전부 1이면 64바이트를 쓴다. 버퍼는 디코더가 이 입력에 실제로 잡는 크기(50바이트, 48 유효 + 2 여유)로 둔다.
// java4shell_oob.c  —  CVE-2026-114938 scalar reconstruction (my own clean-room model)
//
// Faithful SCALAR reconstruction of the INTEGER arithmetic in OpenJDK's x86-64
// Base64 decode stub tail path (stubGenerator_x86_64.cpp: L_finalBit ->
// L_padding -> L_donePadding).  This is NOT the vector (vpermb/evmovdqub)
// execution path — it reproduces the integer operations that compute the
// 64-byte store mask, which is exactly what turns a malformed tail into an
// out-of-bounds heap write.  Built with AddressSanitizer, the single masked
// store trips a real heap-buffer-overflow, on an ordinary CPU with no AVX-512.
//
// Mirrors (jdk-17.0.6-ga):
//   movl   output_size, length          // tail length
//   shrl   output_size, 2               // len / 4
//   lea    output_size,[r+r*2]          // * 3        -> (len/4)*3
//   L_padding: decrementq output_size,1 // one per '=' pad char
//   L_donePadding: movq output_mask,-1
//                  bzhiq output_mask,output_mask,output_size
//   evmovdqub Address(dest,dp), k1=output_mask, zmm   // the 64-byte store
#include <stdint.h>
#include <stdio.h>
#include <string.h>
#include <stdlib.h>
#include <immintrin.h>   // real BZHI (BMI2) — present on Intel N100

int main(int argc, char **argv) {
    // Trigger: "A"*64 + "=" (65 bytes, length % 4 == 1 — a shape no encoder
    // produces).  The 64 'A's are consumed by the main 64-byte block loop
    // (48 bytes of valid output); the lone '=' is the 1-byte tail at L_finalBit.
    size_t trig_len = argc > 1 ? strlen(argv[1]) : 65;   // "A"*64 + "="
    const int tail_len = (int)(trig_len % 64);            // bytes left at L_finalBit = 1

    // movl output_size,length ; shrl output_size,2 ; lea (len/4)*3
    uint64_t output_size = (uint64_t)(tail_len >> 2) * 3;          // (1>>2)*3 = 0
    printf("[arith] tail_len=%d   output_size = (1>>2)*3 = %llu\n",
           tail_len, (unsigned long long)output_size);

    // L_padding: decrementq(output_size,1) per '=' pad char: 0 -> -1
    output_size -= 1;
    printf("[arith] one '=' pad -> decrement -> output_size = 0x%016llx (%lld)\n",
           (unsigned long long)output_size, (long long)output_size);

    // L_donePadding: movq output_mask,-1 ; bzhiq output_mask,output_mask,output_size
    // Index 0xFF = 255 >= 64, so BZHI clears nothing: mask stays all-ones.
    uint64_t output_mask = _bzhi_u64(~0ULL, output_size);         // real BZHI
    int store_bytes = __builtin_popcountll(output_mask);          // set bits -> bytes
    printf("[arith] output_mask = bzhi(-1, output_size) = 0x%016llx -> %d-byte store\n",
           (unsigned long long)output_mask, store_bytes);

    // evmovdqub(Address(dest,dp), k1=output_mask, zmm): 64-byte store at dp=48
    const int dst_size = 50;                // intended (tiny) output buffer
    const int dp = 48;                      // dest write offset after valid data
    unsigned char *dst = (unsigned char *)malloc(dst_size);
    memset(dst, 0x5a, dst_size);            // sentinel = intended contents
    unsigned char zmm[64];
    memset(zmm, 0x41, sizeof zmm);          // the bytes the vector store emits

    printf("[store] dst = malloc(%d); one masked store of %d bytes at dp=%d\n",
           dst_size, store_bytes, dp);
    printf("[store] in-bounds: %d bytes  |  PAST END: %d bytes (dst[%d..%d])\n",
           dst_size - dp, dp + store_bytes - dst_size, dst_size, dp + store_bytes - 1);
    fflush(stdout);

    memcpy(dst + dp, zmm, (size_t)store_bytes);   // <-- ASan: heap-buffer-overflow WRITE
    free(dst);
    return 0;
}tail_len을 입력 길이에서 런타임에 구해, 컴파일러가 상수 접기로 산술을 생략하지 못하게 했다. 그래서 _bzhi_u64가 진짜 BZHI 명령으로 실행된다. 빌드하고 그 사실부터 확인한다.
cc -fsanitize=address -g -O1 -mbmi2 java4shell_oob.c -o java4shell_oob && echo BUILD_OK && objdump -d java4shell_oob | grep -m1 bzhi
bzhi %rbx,%r14,%r14 — 디스어셈블리에 진짜 명령이 박혀 있다. 이제 실행한다. ASan이 붙어 있으니, 50바이트 버퍼의 끝 2바이트만 남겨 두고 64바이트를 쓰는 순간 멈춰야 한다.
ASAN_OPTIONS=detect_leaks=0:color=never ./java4shell_oob 2>&1 | sed -n '1,22p'
산술 사슬이 그대로 찍힌다 — output_size = (1>>2)*3 = 0 → -1 (0xffffffffffffffff) → bzhi(-1, output_size) = 0xffffffffffffffff -> 64-byte store. 그리고 memcpy가 실행되자마자:
ERROR: AddressSanitizer: heap-buffer-overflowWRITE of size 64is located 0 bytes after 50-byte region
N100에서, AVX-512 없이, 진짜 힙 버퍼 오버플로가 떴다. 저장이 dp=48에서 시작해 2바이트는 버퍼 안, 나머지 62바이트가 경계 밖 — 공개 PoC가 보고하는 changed=62 first=50 last=111과 정확히 맞는다.
왜 이걸 "모델"이라고 부르는가
여기서 과장하지 않는 게 중요하다. 방금 ASan이 잡은 건 벡터 명령(vpermb/evmovdqub)의 실행이 아니다. 그 벡터 저장이 "얼마나 쓸지"를 정하는 정수 연산을 1:1로 옮긴 것이고, 바로 그 연산이 OOB를 만든다. 벡터 경로든 스칼라 모델이든 같은 언더플로에서 같은 전부-1 마스크가 나와 64바이트를 쓴다 — 차이는 "실제 저장이 벡터 하드웨어로 일어나느냐"뿐이다.

이 구분을 지키는 이유는 두 가지다. 하나, 정직성 — "N100에서 Java4Shell을 터뜨렸다"고 말하면 거짓이다. 둘, 그래도 이 모델이 가치 있는 이유 — 메모리 손상의 근인(root cause)은 CPU가 아니라 정수 산술이고, 그 산술은 플랫폼 독립적으로 재현·검증된다. 벤더 딥다이브의 "언더플로 → 전부-1 마스크 → 62바이트 OOB"라는 서술이 가설이 아니라 실행 가능한 코드로 확인된다는 것, 그게 이 절의 성과다.
인증 전 도달성 — 공격자 바이트가 디코더에 닿는다
OOB를 만드는 산술은 확인했다. 다음 질문은 공격자 관점에서 더 실질적이다 — 그 디코더에 공격자가 인증 없이 바이트를 넣을 수 있나? HTTP Basic 인증이 교과서적 통로다. 추출한 JDK 17.0.6으로, Authorization: Basic 헤더를 인증 판단 전에 java.util.Base64로 푸는 최소 엔드포인트를 세웠다. 서버 쪽 핵심은 이렇다.
// ReachRaw.java — 요청 헤드를 읽어 Authorization 를 뽑고, 인증 전에 디코드한다
String cred = auth.substring(6);   // attacker-controlled Base64, STILL unauthenticated
System.out.println("[srv/pre-auth] java.util.Base64.getDecoder().decode(cred) cred.len="
    + cred.length() + "  -- no credential check has run");
try {
    Base64.getDecoder().decode(cred);   // <-- the vulnerable surface
} catch (IllegalArgumentException e) {
    System.out.println("[srv/pre-auth] scalar decoder REJECTED: " + e);
    StackTraceElement[] st = e.getStackTrace();
    for (int i = 0; i < Math.min(2, st.length); i++)
        System.out.println("      at " + st[i]);
}
먼저, 이 런타임에서 Base64 인트린식 플래그가 어떤 상태인지 본다.
jdk/17.0.6/bin/java -XX:+PrintFlagsFinal -version 2>&1 | grep -iE 'UseBASE64Intrinsics|UseAVX '
흥미로운 지점이다. 이 17.0.6 런타임은 N100에서 UseAVX=2, 그리고 UseBASE64Intrinsics=false다. 벡터 경로를 깔 수 없는 CPU라, HotSpot이 아예 Base64 인트린식을 생성하지 않는다. (1편의 JDK 21은 같은 N100에서 이 플래그가 true였는데, 빌드별로 인트린식 활성 판정이 다르다. 공통점은 하나 — 어느 쪽이든 VBMI 벡터 스텁은 N100에 없다.) 즉 도달성은 증명하되, 손상은 못 난다. 그 둘을 한 화면에서 본다.
jdk/17.0.6/bin/java -Xrs -Xmx64m -cp labB/reach ReachRaw
서버가 ephemeral 포트에 뜨고, 클라이언트가 실제 TCP 소켓으로 malformed Basic 인증(65바이트·129바이트)을 보낸다. 서버 로그가 결정적이다 — [srv/pre-auth] java.util.Base64.getDecoder().decode(cred)가 "no credential check has run" 상태에서 실행되고, 스택이 java.base/java.util.Base64$Decoder.decode0(Base64.java:838)을 가리킨다. 공격자 바이트가 인증 전에 디코더 본체에 닿았다. N100의 스칼라 디코더는 길이가 4로 나눈 나머지 1인 입력을 "wrong 4-byte ending unit"으로 거부할 뿐이지만, 핵심은 표면의 도달성이다 — VBMI 호스트였다면 이 거부 예외가 던져지기 전에 벡터 스텁이 이미 힙을 덮어썼을 자리다.
공개 PoC의 익스플로잇 전략 — 코드 리딩으로 해부
62바이트 고정값 오버플로 하나로 어떻게 힙 정보 노출, 나아가 RCE까지 간다는 걸까. 공개 PoC(github.com/ikow/java4shell-poc, 저자 Qi Deng, MIT)를 격리 랩에서 코드 리딩으로만 뜯어봤다 — 받아서 실행하지 않았고, 애초에 N100엔 발화할 벡터 경로도 없다. 리뷰 결과 외부 비컨·Runtime.exec는 없고 손상→힙릭 프리미티브까지만 시연한다.
1단계는 Writer 프리미티브다. 62바이트 오버플로를 인접 배열의 길이 필드(헤더 오프셋 +16, mark 8 + klass 4 + length 4)에 떨궈, 그 배열의 경계를 늘린다.
git show HEAD:exploit/WriterPrimitive.java | sed -n -e '28,38p' -e '142,151p'
상수가 우리 ASan 모델과 정확히 같다 — DECODE_BUF_SIZE = 50, OVERFLOW_SIZE = 62, OVERFLOW_START = 48. 우리가 C로 재현한 바로 그 숫자다. 길이가 깨진 배열은 JVM이 그 값을 믿으므로, 원래 경계 너머로 읽고 쓸 수 있게 된다.
2단계 JavaBleed — Writer로 두 번째 "reader" 배열의 길이를 늘려, 원래 경계 너머 힙을 읽는다.
git show HEAD:exploit/JavaBleed.java | sed -n -e '49,57p' -e '236,243p'
이름이 Heartbleed를 빗댄 이유가 여기 있다 — reader 배열의 내용이 HTTP 응답에 실려 나가면, 그 안에 세션 토큰·개인키·PII 같은 이웃 힙 객체가 섞여 나온다. 손상이 "읽기 누출"로 바뀌는 지점이다.
3단계 Heap Feng Shui — 이 모든 게 배열들이 메모리에서 인접해야 성립한다. G1 GC의 TLAB(bump-pointer)를 길들여 레이아웃을 제어한다.
git show HEAD:exploit/HeapFengShui.java | sed -n -e '11,25p' -e '34,39p'
네 기법 — TLAB 소진, 배열 쌍 스프레이, GC 압력 조절, 정렬 패딩 — 이 "확률적 컴포넌트"이고, PoC 스스로 "익스플로잇을 만들고 깨는 부분"이라고 적는다. 이 단계들을 엮은 게 풀체인이다.
git show HEAD:exploit/Java4ShellExploit.java | sed -n -e '283,287p' -e '325,334p'
원격 경로가 여섯 단계로 요약된다 — WARM(인증 요청 수십만 번으로 C2가 인트린식을 컴파일하도록 가열) → GROOM(TCP ACK 타이밍으로 서버 힙 할당 순서 제어) → TRIGGER(malformed Basic 전송) → DISCLOSE(응답에 실린 힙 데이터 회수) → REPAIR(누출한 원본값으로 헤더 복원) → ESCALATE(임의 R/W로 vtable 덮어 RCE). 이 사슬을 한 장의 그림으로 정리하면 이렇다.

그래서 "pre-auth RCE"는 왜 주장인가
위 사슬을 보면 왜 우리가 RCE를 우리 결과로 말하지 않는지 분명해진다. 손상(62바이트 고정값)에서 임의 R/W까지는 힙 펑슈이가 받쳐줘야 하고, 그건 타깃 애플리케이션마다 할당 크기·GC 거동·인증 흐름이 달라 전용 프로파일이 필요하다. PoC 저자도 "범용 익스는 없다"고 못박는다.

Source: oss-security — CVE-2026-114938 (2026-11-17)
정리하면 공개된 증거의 신뢰도 등급은 이렇다. 소스로 확정: 정수 언더플로 → 전부-1 마스크 → 64바이트 저장(우리 ASan이 재현). 공개 PoC로 시연: Writer·JavaBleed 프리미티브(VBMI 호스트에서). Calif.io 주장: Keycloak·Jira·Confluence·Jenkins·Artifactory·PingFederate에 대한 기본 구성 pre-auth RCE. 마지막 항목은 레포에 무기화 셸이 없으니, 독립 검증 전엔 주장으로 둔다.
패치 — length 4 미만 가드 한 줄
픽스는 나와 있다. OpenJDK 어드바이저리(2026-11-17)와 Oracle CPU(2026-11)가 동시에 공개됐고, 커밋은 JDK-8393212다. 취약↔패치 diff를 실제로 떠 본다 — 1편에서 "소스 diff는 아직 공개 전"이라고 적었던 그 증거를, 이번엔 확보했다. 픽스 커밋 5177a70b는 미리 openjdk/jdk에서 jdkfix 폴더로 fetch해 뒀고, 아래 스크립트가 그 커밋과 가드를 출력한다.
#!/usr/bin/env bash
# patch_show.sh — the real OpenJDK fix for CVE-2026-114938 (JDK-8393212).
# Shows the fix commit and the exact guard it adds to the decode stub.
set -u
cd "$(dirname "$(readlink -f "$0")")"
F=src/hotspot/cpu/x86/stubGenerator_x86_64.cpp
echo "# fix commit (openjdk/jdk):"
git log --oneline -1 FETCH_HEAD | sed 's/^/  /'
echo "# files changed:"
git show --stat FETCH_HEAD -- "$F" 2>/dev/null | grep -E 'stubGenerator|insertion' | sed 's/^/  /'
echo
echo "# the guard (generate_base64_decodeBlock, right after BIND(L_finalBit)):"
git show FETCH_HEAD -- "$F" 2>/dev/null | sed -n '/@@/,/let Java take care/p'bash patch_show.sh
픽스는 단 한 파일, 4줄 추가다. BIND(L_finalBit) 바로 뒤에 가드가 들어간다.
__ BIND(L_finalBit);
// Now have 1 to 63 bytes left to decode
+// A padded Base64 tail shorter than one complete block is handled by Java.
+__ cmpl(length, 4);
+__ jcc(Assembler::less, L_bruteForce);
간단하지만 정확히 급소를 찌른다. 우리 트리거의 꼬리는 = 한 글자(길이 1)였고, 바로 그 length = 1이 output_size = (1 / 4) * 3 = 0 → -1 언더플로의 출발점이었다. 패치는 길이가 4 미만인 꼬리를 벡터 처리에 들이지 않고 안전한 스칼라 L_bruteForce로 보낸다. 언더플로가 일어날 자리에 도달하기 전에 분기하니, 프리미티브 자체가 사라진다.

Source: NVD — CVE-2026-114938
픽스 릴리스는 17.0.21.1 · 21.0.13.1 · 25.0.5.1 · 27.0.1.1이다. 라이브러리가 아니라 JVM 자체를 올려야 하므로, 컨테이너 베이스 이미지·번들 JRE·임베디드 런타임까지 교체 대상이다.
탐지 재현 — 방어자의 진짜 성과
여기가 공격자-방어자 교환의 실질 성과다. 벡터 발화는 CPU를 타지만, 탐지는 CPU와 무관하게 완전히 재현된다. 트리거는 네트워크에 또렷한 지문을 남긴다 — "정상 인코더가 만들 수 없는 malformed Base64". 로컬 리스너(127.0.0.1:9999)에 네 유형의 트리거 트래픽을 쏘고 tcpdump로 pcap을 떴다. 트래픽 생성 스크립트 전문은 이렇다 — 65·129바이트 Basic, Bearer, 그리고 워밍업 40회를 순서대로 쏜다.
#!/usr/bin/env bash
# make_pcap.sh — capture Java4Shell trigger traffic to a pcap for offline IDS replay.
# A throwaway HTTP listener on 127.0.0.1:9999 completes each request so Suricata's
# HTTP parser sees full transactions; tcpdump records them on the loopback.
set -u
cd "$(dirname "$(readlink -f "$0")")"
PORT=9999
PCAP=trigger.pcap
A64=$(printf 'A%.0s' $(seq 1 64))
A128=$(printf 'A%.0s' $(seq 1 128))

python3 -m http.server "$PORT" --bind 127.0.0.1 >/dev/null 2>&1 &
LISTENER=$!
sudo -n tcpdump -i lo -w "$PCAP" "tcp port $PORT" >/dev/null 2>&1 &
TCPDUMP=$!
sleep 1.5

U="http://127.0.0.1:$PORT/api/token"
# 1) JDK21+ trigger: malformed Basic, "A"x64 + "="
curl -s -o /dev/null -H "Authorization: Basic ${A64}=" "$U"
# 2) JDK17 trigger: malformed Basic, "A"x128 + "="
curl -s -o /dev/null -H "Authorization: Basic ${A128}=" "$U"
# 3) JWT Bearer variant: malformed base64url segment
curl -s -o /dev/null -H "Authorization: Bearer eyJ0eXA.${A64}=.c2ln" "$U"
# 4) JIT warm-up burst: many Base64 Basic-auth requests from one source
for i in $(seq 1 40); do
  curl -s -o /dev/null -H "Authorization: Basic ${A64}=" "$U"
done

sleep 1
sudo -n kill "$TCPDUMP" 2>/dev/null
kill "$LISTENER" 2>/dev/null
wait 2>/dev/null
PKTS=$(sudo -n tcpdump -r "$PCAP" 2>/dev/null | wc -l)
echo "wrote $PCAP  ($PKTS packets, $(du -h "$PCAP" | cut -f1))"
pcap이 생겼으니 그 안에 어떤 malformed 헤더가 실렸는지 뽑아 본다. 아래 스크립트가 그 출력을 만든다.
#!/usr/bin/env bash
# show_traffic.sh — the malformed Authorization headers actually captured on the wire.
cd "$(dirname "$(readlink -f "$0")")"
echo "# distinct malformed Authorization headers in trigger.pcap (A-runs truncated to 40):"
tcpdump -r trigger.pcap -A 2>/dev/null \
  | grep -aoE 'Authorization: (Basic|Bearer) [A-Za-z0-9+/._-]{1,40}' \
  | sort | uniq -c | sed 's/$/.../'
echo "# total packets: $(tcpdump -r trigger.pcap 2>/dev/null | wc -l) (65-byte + 129-byte Basic, Bearer, + 40-req warm-up burst)"bash show_traffic.sh
Basic AAAA...(길이 나머지 1), 128개 변종, Bearer eyJ...=.sig, 그리고 워밍업 버스트까지 — 549패킷이 실제로 캡처됐다. 이제 이 pcap을 Suricata로 재생한다. 리뷰된 저장소의 룰(java4shell.rules, 6개)과, 그 룰의 pcre 상대 앵커 한계를 보완한 튜닝 룰(java4shell_tuned.rules, 4개)을 함께 돌리는 스크립트 전문은 이렇다. HOME_NET을 루프백으로 두고 체크섬 검증을 끈(-k none) 채 오프라인 재생한다.
#!/usr/bin/env bash
# run_suricata.sh — replay the captured Java4Shell trigger pcap through Suricata
# and print the alerts. HOME_NET is set to the loopback target so the
# $EXTERNAL_NET -> $HOME_NET rules match the replayed 127.0.0.1 traffic.
set -u
cd "$(dirname "$(readlink -f "$0")")"
RULES="${1:-java4shell.rules}"
run() {
  local rules="$1" out="$2"
  rm -rf "$out" && mkdir -p "$out"
  suricata -r trigger.pcap -k none -S "$rules" -l "$out" \
    --set vars.address-groups.HOME_NET="[127.0.0.1/32]" \
    --set vars.address-groups.EXTERNAL_NET="any" >/dev/null 2>&1
}

echo "Suricata $(suricata -V 2>&1 | grep -oE '[0-9]+\.[0-9]+\.[0-9]+')  |  pcap: trigger.pcap ($(ls -la trigger.pcap | awk '{print $5}') bytes)"
echo

run "$RULES" out
echo "### reviewed repo rules: $RULES"
grep -c '^alert' "$RULES" | sed 's/^/  signatures loaded: /'
grep -o '"signature":"[^"]*"' out/eve.json | sed 's/"signature":"//; s/"$//' | sort | uniq -c | sort -rn \
  | sed 's/^/  ALERT x/'
echo "  total alerts: $(grep -c '"event_type":"alert"' out/eve.json)"
echo

run java4shell_tuned.rules outt
echo "### tuned companion rules: java4shell_tuned.rules"
grep -c '^alert' java4shell_tuned.rules | sed 's/^/  signatures loaded: /'
grep -o '"signature":"[^"]*"' outt/eve.json | sed 's/"signature":"//; s/"$//' | sort | uniq -c | sort -rn \
  | sed 's/^/  ALERT x/'
echo " total alerts: $(grep -c '"event_type":"alert"' outt/eve.json)"bash run_suricata.sh
경보가 쏟아진다. 리뷰 저장소 룰은 정확-트리거 content 시그니처(64×A+=, 128×A+=)로 44건, 튜닝 룰은 네 유형 모두 발화해 87건이다.
위 경보가 정확히 어느 룰에서 나왔는지, 자작 튜닝 룰 4개 전문을 붙인다(java4shell_tuned.rules). http.header 스티키 버퍼에 /Hi(비상대) pcre로 걸어, 저장소 룰의 /R 상대 앵커 문제를 피한다.
# T1 — Basic auth with malformed base64 padding (length %4 == 1: single '=' tail)
alert http any any -> any any (msg:"JAVA4SHELL(tuned) Basic malformed base64 padding len%4==1 (CVE-2026-114938)"; flow:to_server,established; http.header; content:"Authorization|3a 20|Basic "; nocase; pcre:"/Basic\s+(?:[A-Za-z0-9+\/]{4})+=(?:\s|\r?\n|$)/Hi"; classtype:attempted-admin; sid:2026114911; rev:1;)

# T2 — long monotonic base64 run (the 'A'x64 / 'A'x128 trigger body)
alert http any any -> any any (msg:"JAVA4SHELL(tuned) long monotonic base64 A-run in auth material (CVE-2026-114938)"; flow:to_server,established; http.header; pcre:"/(?:Basic|Bearer)\s+[^\r\n]*?A{64,}=/Hi"; classtype:attempted-admin; sid:2026114912; rev:1;)

# T3 — JWT Bearer token with malformed base64url segment
alert http any any -> any any (msg:"JAVA4SHELL(tuned) Bearer malformed base64url segment (CVE-2026-114938)"; flow:to_server,established; http.header; content:"Authorization|3a 20|Bearer "; nocase; pcre:"/Bearer\s+[A-Za-z0-9_\-]+\.[A-Za-z0-9_\-]{64,}=[.]/Hi"; classtype:attempted-admin; sid:2026114913; rev:1;)

# T4 — JIT warm-up burst: many Base64 Basic-auth requests from one source (lab threshold 20)
alert http any any -> any any (msg:"JAVA4SHELL(tuned) intrinsic warm-up burst from single source (CVE-2026-114938)"; flow:to_server,established; http.header; content:"Authorization|3a 20|Basic "; nocase; threshold:type both, track by_src, count 20, seconds 60; classtype:attempted-dos; sid:2026114914; rev:1;)
캡쳐의 경보 이름(long monotonic base64 A-run·Basic malformed base64 padding len%4==1·Bearer malformed base64url segment·intrinsic warm-up burst)이 위 네 룰의 msg와 1:1로 대응한다. 정리하면 방어자가 가져갈 신호는 넷이다 — ① Basic 인증의 길이 나머지 1 패딩, ② A가 64개/128개 이어지는 단조로운 긴 런, ③ Bearer 세그먼트의 malformed base64url, ④ 단일 출발지의 워밍업 버스트(C2 가열 신호). 이걸 파이프라인으로 보면 이렇다.

주의 한 가지 — 리뷰 저장소의 정규식 룰(sid 2026114901·906)은 pcre를 선행 content에 상대(/R) 로 걸어, 이미 소비한 Basic/Bearer를 다시 찾으려다 발화하지 않는다. 반면 정확-트리거 content 룰(sid 902·903)은 모든 트리거 요청과 워밍업 버스트에서 안정적으로 발화한다. 방어자는 그 content 룰을 바로 쓰되, 모양 기반 탐지는 위 튜닝 룰처럼 http.header 스티키 버퍼에 비상대 pcre로 거는 게 낫다.
환경 한계 — 벡터 실발화는 네이티브 VBMI만
마지막으로, 못 한 것을 정직하게 못박는다. 1편의 타당성 조사대로, 로컬에서 진짜 벡터 OOB는 발화시킬 수 없다. QEMU TCG는 AVX-512를 구현하지 않고, N100엔 애초에 없다. 둘 다 재확인하는 스크립트는 이렇다 — ① QEMU user-mode로 vbmi_probe를 돌려 vpermb를 실행해 보고, ② 추출 JDK 17.0.6으로 진짜 트리거를 B64Corrupt에 먹인다.
#!/usr/bin/env bash
# env_limit.sh — honest environment limit: the AVX-512 VBMI vector path cannot
# fire on this hardware. QEMU TCG strips the CPUID bits and faults on vpermb;
# the N100 lacks the feature so java.util.Base64 falls back to the safe scalar path.
set -u
cd "$(dirname "$(readlink -f "$0")")"
JDK=/home/jinho/Dev/Hacking_Project/프로젝트/Java4Shell_CVE-2026-114938/jdk/17.0.6

echo "# (1) AVX-512 VBMI probe under QEMU user-mode emulation (TCG), -cpu Icelake-Server"
qemu-x86_64 -cpu Icelake-Server ./vbmi_probe 2>&1 \
  | grep -E 'avx512f |avx512bw |avx512vbmi |CPUID\.7|executing vpermb|Illegal instruction' \
  | sed 's/^qemu-x86_64: warning: /  warn: /; s/^qemu: /  /'
echo "  => TCG reports AVX512_VBMI=0 and faults on the first vpermb (SIGILL)"
echo
echo "# (2) real \"A\"x128 + \"=\" trigger via java.util.Base64 (B64Corrupt), native on Intel N100"
"$JDK/bin/java" -cp . B64Corrupt 2>&1 | sed 's/^/  /'
echo " => no AVX-512 VBMI here -> the vulnerable vector stub is never generated -> changed=0"bash env_limit.sh
두 증거가 나란히 나온다. ① QEMU user-mode(TCG)에서 Icelake-Server를 지정해도 AVX-512 CPUID 비트를 경고와 함께 strip하고(AVX512_VBMI=0), 첫 vpermb 실행에서 SIGILL(신호 4). ② 추출 JDK 17.0.6으로 진짜 "A"×128 + "=" 트리거를 먹인 B64Corrupt는 rejected=true changed=0 — 손상 없음(VBMI 스텁이 안 잡혀 스칼라 경로로 떨어진다). 진짜 62바이트 OOB를 벡터 하드웨어로 보려면 네이티브 AVX-512 VBMI CPU(Ice Lake+·Sapphire Rapids·Zen 4+)가 있어야 한다. 이건 약점이 아니라 범위를 정직하게 그은 것이다 — 우리가 재현한 건 OOB를 만드는 산술과 그 도달성·탐지이지, 벡터 실행이 아니다.

Source: GitHub Security Advisory — GHSA-6g7j-4xh3-xq2q
방어 — 우선순위는 분명하다
메커니즘을 끝까지 따라왔으니 방어는 간결하게 정리된다.
- ① JVM 패치가 근본책. 17.0.21.1 / 21.0.13.1 / 25.0.5.1 / 27.0.1.1로 올린다. 라이브러리가 아니라 런타임이라, 컨테이너 베이스 이미지·번들 JRE·임베디드 런타임까지 버전 인벤토리를 훑는다.
- ② 패치 전엔 인트린식 차단.
-XX:-UseBASE64Intrinsics가 1순위다(영향이 Base64 처리량에만 국한).-XX:UseAVX=2는 AVX-512 전체를 내려 영향 범위가 넓고, ARM JVM엔 쓰면 안 된다. N100처럼 비-AVX-512 호스트에서는 애초에 벡터 스텁이 없어 이 완화가 이미 적용된 상태다. - ③ 탐지로 프로브를 가시화. 위에서 재현한 Suricata 룰 — 특히 정확-트리거 content 룰과 모양 기반 튜닝 룰 — 로 malformed Base64·단조 런·워밍업 버스트를 잡는다. 취약 호스트라면
hs_err_pid크래시 로그와 요청 직후 연결 리셋/5xx 급증도 사후 지표다. - ④ 자가 점검. 돌아가는 프로세스의 JVM으로
java -version(픽스 전 구간인지),lscpu | grep avx512_vbmi(비면 이 경로 해당 없음),java -XX:+PrintFlagsFinal -version | grep base64(인트린식 상태)를 함께 본다.
벡터 경로가 CPU를 타니 "우리는 ARM이라/구형 x86이라 안전"일 수 있지만, 그 교집합을 외부에서 세는 건 불가능에 가깝다. 버전 + 호스트 CPU를 함께 훑는 게 가장 실용적이다.
정리 — 1편은 왜, 2편은 어디까지
1편이 "소스로 근본 원인을 교차검증한 분석"이었다면, 2편은 "우리 하드웨어에서 되는 것만 진짜로 재현한 안전 재현"이다. 둘을 합치면 Java4Shell의 그림이 선명해진다.
- 재현함(실측): 취약 스텁의 정수 산술을 1:1로 옮긴 스칼라 모델 → N100에서 ASan
heap-buffer-overflow WRITE 64. 추출 JDK 17.0.6에 세운 엔드포인트로 인증 전java.util.Base64.decode0도달. 트리거 pcap에 대한 Suricata 경보. 픽스 커밋5177a70b의 length 4 미만 가드 git diff. - 코드 리딩만: 공개 PoC의 Writer·JavaBleed·Feng Shui·풀체인 — 실행 아님, 소스 해부.
- 못 함/주장: 벡터 경로 실발화(네이티브 AVX-512 VBMI 필요)와 pre-auth RCE(Calif.io·공개 PoC 주장, 레포에 무기화 셸 없음).
공격자 관점의 교훈은 1편과 같되 한 겹 더 구체적이다 — 메모리 손상의 근인은 CPU가 아니라 정수 산술이고, 그 산술은 평범한 노트북에서도 ASan 한 번에 드러난다. 사람 눈이 잘 안 가던 인트린식 어셈블리를 AI가 한 시간에 훑어 찾아낸 버그가, 이렇게 플랫폼 독립적으로 분해된다. 당신 인프라에서 가져갈 한 가지는 여전히 같다 — JVM 버전과 호스트 CPU를 함께 훑고, 그 전에 탐지 룰부터 걸어 둬라.


Comments
댓글
댓글을 남기려면 로그인이 필요해요. (네이버 · 구글 계정)
댓글 불러오는 중…