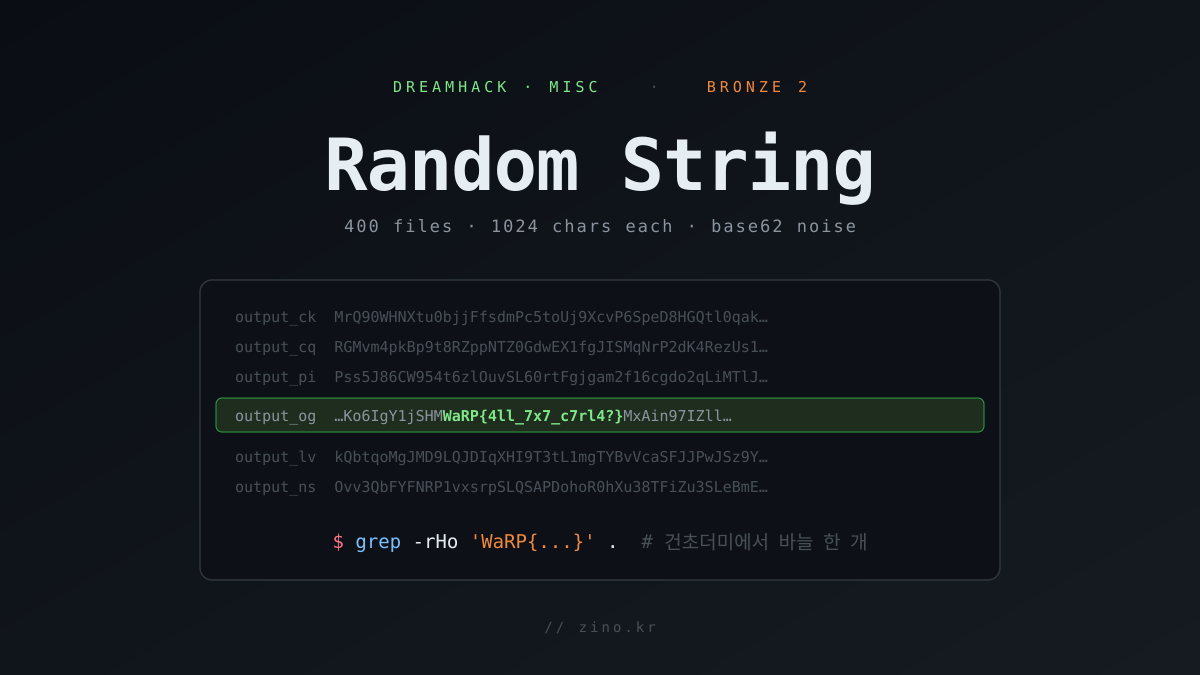
문제: DreamHack — Random String 분류: Misc 난이도: 🥉 Bronze 2 FLAG:
WaRP{4ll_7x7_c7rl4?}
출제자가 붙인 설명은 한 줄이다. "Can you find the flag in this enormous bunch of files?" 압축을 풀면 output_aa부터 시작하는 파일이 끝도 없이 이어진다. 전부 똑같이 생긴 난수 문자열이라 하나씩 열어 봐서는 답이 없다. 이 문제는 "눈"이 아니라 "도구"로 푸는 문제라는 걸 알아채면 1분이면 끝나지만, 그 전에 데이터가 어떻게 생겼는지부터 제대로 보는 습관을 연습하기에 좋은 입문용 포렌식이다.
먼저 압축을 풀고 디렉토리가 어떻게 생겼는지 훑는다. 파일이 몇 개인지, 타입은 무엇인지, 한 파일의 앞부분은 어떤 모양인지 한 번에 본다.
echo "파일 개수:"; ls output_* | wc -l; echo "샘플:"; ls | sed -n "1,4p"; echo "타입/크기:"; file output_og; wc -c output_og; echo "앞 110글자:"; head -c 110 output_og; echo
파일은 400개, 전부 1024바이트짜리 한 줄 ASCII 텍스트다. 파일명은 output_aa, output_ab, … 처럼 알파벳 두 글자가 붙어 순서대로 늘어선다. 이 aa, ab, ac … 접미어는 리눅스 split 명령이 큰 파일을 조각낼 때 붙이는 바로 그 형식이다. 즉 출제자는 40만 글자짜리 난수 블롭 하나를 만들어 플래그를 끼워 넣고 split -b 1024로 1024바이트씩 잘라 400개 파일로 흩뿌렸을 가능성이 높다(400 × 1024 = 409,600바이트로 딱 떨어진다). 그렇다면 플래그는 조각 경계에 걸려 두 파일에 나뉘어 있을 수도 있다는 뜻이기도 하다 — 이 점은 뒤에서 다시 확인한다.
미리보기로 띄운 output_og는 공교롭게도 답이 들어 있는 파일이라 앞부분에서 플래그가 걸렸지만, 정찰 시점에는 400개 중 어느 파일이 그 파일인지 알 수 없다. 사람 눈으로 전부 확인하는 건 애초에 전제가 틀린 접근이다.
문제 개요
| 항목 | 내용 |
|---|---|
| 문제명 | Random String |
| 난이도 | 🥉 Bronze 2 |
| 분류 | Misc |
| 제공 파일 / 서버 | random_string/output_aa … output_* 400개 (서버 없음, 오프라인) |
| 핵심 기법 | 재귀 grep으로 플래그 포맷 검색 — 건초더미에서 바늘 한 개 |
풀이 흐름은 세 걸음이다. ① 파일 더미가 무엇인지 통계로 파악하고 ② 플래그가 한 파일에 통째로 들어 있는지 여러 파일에 쪼개져 있는지 가린 다음 ③ 그 한 파일을 grep으로 찾는다. 바로 grep부터 때려도 풀리지만, 데이터의 성질을 먼저 정의해 두면 포맷을 모를 때도 길이 열린다.
🔬 정찰 — 이 더미는 무엇인가
눈으로 못 읽는 데이터를 만났을 때 가장 먼저 할 일은 "정상이 무엇인지"를 수치로 정의하는 것이다. 파일 수와 크기가 고른지, 어떤 문자들이 쓰였는지, 글자 분포가 치우쳤는지를 보면 숨은 구조가 있는지 없는지가 드러난다. 아래 profile.py가 그걸 한 번에 뽑는다.
#!/usr/bin/env python3
# profile.py — 나눠진 파일 더미가 "진짜 랜덤 문자열"인지 통계로 확인한다.
import collections, math, os, glob

D = "../extracted/random_string"
files = sorted(glob.glob(os.path.join(D, "output_*")))
print(f"[files]  총 {len(files)}개")

sizes = collections.Counter(os.path.getsize(f) for f in files)
print(f"[size]   파일 크기 분포 = {dict(sizes)}  (모두 동일하면 1종류)")

data = "".join(open(f).read() for f in files)
charset = sorted(set(data))
print(f"[charset] 사용 문자 {len(charset)}종 = {''.join(charset)}")

freq = collections.Counter(data)
total = len(data)
H = -sum((c/total) * math.log2(c/total) for c in freq.values())
print(f"[entropy] 글자당 {H:.4f} bits (62종 균등이면 이론상 {math.log2(62):.4f})")

top = freq.most_common(3)
bot = freq.most_common()[-3:]
print(f"[bias]   최빈 {top}  /  최소 {bot}")
print(f"[total] 전체 {total:,} 글자 — 눈으로 플래그를 찾는 건 사실상 불가능")python3 profile.py
출력이 많은 걸 알려 준다.
- 400개 파일이 전부 1024바이트다. 크기가 한 종류뿐이라는 건, 파일마다 길이가 다른 "조각"을 담았을 가능성이 낮다는 신호다.
- 글자당 엔트로피가 5.9543비트로, 62종을 균등하게 뽑았을 때의 이론값
log2(62) ≈ 5.9542비트와 소수 셋째 자리까지 겹친다. 어떤 글자도 특별히 자주 나오지 않는, 말 그대로 균등 난수라는 뜻이다. 패턴이 없으니 "재조합하면 플래그가 된다" 같은 접근은 성립하기 어렵다. - 그런데 사용 문자가 62종이 아니라 66종이다. base62(
0-9,A-Z,a-z)에 없는{,},?,_가 섞여 있고, 빈도를 보면{·?·}가 딱 1번씩만 등장한다. 난수에는 나올 수 없는 글자들 — 플래그가 흘린 흔적이다.
엔트로피 숫자 하나로는 감이 잘 안 오니 글자별 등장 횟수를 그림으로 그려 둔다. 균등하다는 말이 눈에 보이게 된다.
#!/usr/bin/env python3
# freq_chart.py — 전체 40만 글자의 글자별 등장 횟수를 막대그래프로 그린다.
import collections, glob
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

files = sorted(glob.glob("../extracted/random_string/output_*"))
data = "".join(open(f).read() for f in files)
freq = collections.Counter(data)

base62 = "0123456789" + "".join(chr(c) for c in range(65, 91)) + "".join(chr(c) for c in range(97, 123))
special = "{}_?"
chars = list(base62) + list(special)
counts = [freq.get(c, 0) for c in chars]
colors = ["#4e79a7"] * len(base62) + ["#e15759"] * len(special)

plt.figure(figsize=(14, 4.2))
plt.bar(range(len(chars)), counts, color=colors, width=0.9)
plt.xticks(range(len(chars)), chars, fontsize=7, family="monospace")
exp = len(data) / 62
plt.axhline(exp, color="#59a14f", ls="--", lw=1, label=f"uniform-over-62 expectation = {exp:.0f}")
plt.title("Character frequency across all 400 output_* files  (base62 = blue, flag-only chars = red)", fontsize=11)
plt.ylabel("count")
plt.legend(fontsize=9, loc="upper right")
plt.tight_layout()
OUT = "/home/jinho/homepage/public/images/blog/dreamhack-random-string-writeup/03_freq.png"
plt.savefig(OUT, dpi=120, facecolor="white")
print("saved", OUT)python3 freq_chart.py
파란 막대 62개가 기대값 선(약 6606회) 언저리에서 고르게 춤춘다. 오른쪽 끝에 붙은 빨간 막대 넷({, }, _, ?)은 전부 1회라 눈금에서는 바닥에 깔려 거의 보이지도 않는다. "균등 난수 + 플래그가 흘린 특수문자 몇 개"라는 그림이 한눈에 들어온다.
🧪 플래그는 쪼개져 있나 — 가설 걷어내기
"파일이 엄청 많다"는 설명을 보면 흔히 떠올리는 접근이 있다. 파일마다 한 글자씩 담아 두고, 같은 위치의 글자를 파일 순서대로 이어 붙이면 플래그가 나오는 식의 세로 읽기다. 엔트로피가 이미 균등이라 가능성은 낮지만, 입문 단계에서는 직접 확인해 보는 게 낫다. 각 파일의 같은 열(column)을 파일명 순서로 모아 봤다.
#!/usr/bin/env python3
# columns.py — "파일마다 한 글자씩 담아 세로로 읽는다"는 가설을 검증한다.
import glob
files = sorted(glob.glob("../extracted/random_string/output_*"))
rows = [open(f).read() for f in files]
print(f"[files]   {len(files)}개 · 각 {len(rows[0])}글자")
for col in (0, 45, 100):
    s = "".join(r[col] for r in rows)
    print(f"[col {col:>3}] {s[:48]}…")
print("[verdict] 세로로 읽어도 난수 — 플래그는 쪼개져 있지 않다")python3 columns.py
0번·45번·100번 열 어디를 세로로 읽어도 또 다른 난수가 나온다. 세로 읽기·재조합 가설은 여기서 접는다. 결론은 분명하다. 플래그는 쪼개져 있지 않고, 한 파일 안에 통째로 들어 있다. 남은 일은 400개 중 그 한 파일을 찾는 것뿐이다.
🎯 풀이 — 두 가지 길, 같은 파일
길 1 — 플래그 포맷을 그대로 검색
플래그 형식 WaRP{...}를 알고 있으니 디렉토리 전체에서 그 패턴을 재귀로 찾으면 된다. grep -r에 -o(매칭한 부분만 출력), -H(파일명 표시)를 붙인다. WaRP{[^}]*}는 "WaRP{로 열고 }가 아닌 글자가 이어지다 }로 닫히는" 부분을 잡는 정규식이다.
길 2 — 포맷을 몰랐다면
정찰에서 base62에 없는 {, }, ?, _가 플래그에서만 나온다는 걸 봤다. 플래그 포맷을 모른다 해도 "난수답지 않은 글자가 박힌 파일" 을 찾으면 같은 결론에 닿는다. grep -l '[{}?]'는 대괄호 안 글자 중 하나라도 품은 파일의 이름만 출력한다.
아래 solve.sh가 두 길을 나란히 돌린다.
#!/usr/bin/env bash
# solve.sh — 400개 파일 더미에서 플래그를 뽑는 두 가지 길.
D=../extracted/random_string

echo "[1] 플래그 포맷(WaRP{...})을 그대로 grep — 가장 곧장"
grep -rHo 'WaRP{[^}]*}' "$D"

echo
echo "[2] 포맷을 몰라도: base62에 없는 글자({ } ?)가 박힌 파일을 역추적"
grep -rl '[{}?]' "$D"./solve.sh
두 길 모두 output_og 하나를 가리킨다. 400개 중 플래그를 품은 파일은 이것뿐이다. 앞서 "split로 잘렸다면 플래그가 두 파일 경계에 걸쳐 있을 수도 있다"고 적어 뒀는데, 길 1의 파일별 grep이 WaRP{부터 }까지 완전한 플래그를 한 파일에서 그대로 뽑아냈다는 건 경계에 걸리지 않았다는 뜻이다. 만약 쪼개졌다면 cat output_* | grep 처럼 전부 이어 붙여 검색해야 했을 것이다.
길 2가 정말 "운 좋게 하나만 걸린 것"이 아니라 구조적으로 하나뿐임을 확인해 둔다. 특수문자별로 그 글자를 품은 파일 수를 세어 보면 넷 다 1이어야 한다.
#!/usr/bin/env bash
# crosscheck.sh — base62에 없는 글자별로 그 글자를 품은 파일 수를 센다.
D=../extracted/random_string
for ch in '{' '}' '?' '_'; do
  printf "글자 %s 를 품은 파일 수: " "$ch"
  grep -lF "$ch" "$D"/* | wc -l
done
echo "→ 넷 다 같은 파일 하나(output_og)에만 몰려 있다"./crosscheck.sh
{, }, ?, _ 네 글자 모두 파일 1개에만 존재한다. base62 난수 40만 글자 어디에도 이 글자들은 섞여 들어가지 않았으니, 특수문자가 보이는 순간 그 파일이 답이다.
🔎 플래그는 파일 어디에 숨어 있었나
찾은 파일 안에서 플래그가 어느 위치에 박혔는지 확인한다. locate.py가 바이트 오프셋과 앞뒤 난수 문맥을 보여 준다.
#!/usr/bin/env python3
# locate.py — output_og 안에서 플래그가 박힌 위치와 앞뒤 문맥을 보여준다.
s = open("../extracted/random_string/output_og").read()
i = s.find("WaRP{")
j = s.find("}", i) + 1
print(f"[len]     output_og = {len(s)} 글자")
print(f"[offset]  플래그는 {i}~{j}번째 바이트")
print(f"[before]  …{s[i-20:i]}")
print(f"[FLAG]    {s[i:j]}")
print(f"[after] {s[j:j+20]}…")python3 locate.py
플래그는 1024글자 중 45번째 바이트에서 시작한다. 앞뒤가 모두 난수라 사람 눈에는 그냥 또 하나의 난수 조각처럼 보이지만, grep에게는 {로 열고 }로 닫히는 또렷한 경계다. 바이트 단위로 한 번 더 확인하면 더 분명하다.
xxd -s 45 -l 32 output_og
57 61 52 50 7b가 그대로 WaRP{다. 인코딩도 압축도 없이 날것 그대로 끼워 넣은 것이라, 패턴만 알면 grep이 단숨에 집어낸다.
✅ 플래그 제출
찾은 플래그를 그대로 제출한다.
python3 dreamhack.py wg 1838 --flag "WaRP{4ll_7x7_c7rl4?}"
플래그 WaRP{4ll_7x7_c7rl4?}를 leet로 읽으면 4는 a, 7은 t이니 "all txt ctrl" 쯤 된다. 수많은 텍스트(all txt)를 Ctrl로 뒤지라는, 풀이법 자체를 담은 말장난이다. 파일을 하나씩 여는 대신 전체 텍스트를 한 번에 검색하라는 힌트가 플래그에 박혀 있었던 셈이다.
🧰 같은 답을 내는 다른 한 줄들
grep -rHo 'WaRP{[^}]*}' . 말고도 길은 여럿이다. 상황에 맞게 고르면 된다.
grep -rl 'WaRP{' .— 플래그를 품은 파일 이름만 뽑는다. 먼저 어느 파일인지 특정하고 따로 열어 보고 싶을 때.grep -rho 'WaRP{[^}]*}' .— 플래그 문자열만, 파일명 없이 출력한다(-h가 파일명을 뗀다). 바로 복사해서 제출하기 좋다.cat output_* | grep -o 'WaRP{[^}]*}'— 400개를 한 스트림으로 이어 붙여 한 번에 검색한다. 파일이 한 폴더에 평평하게 있을 때.strings output_* | grep WaRP— 중간에 텍스트가 아닌 파일이 섞여 있어도 출력 가능한 문자열만 걸러서 본다. 바이너리 더미를 뒤질 때 특히 유용하다.
재귀 옵션 -r은 하위 폴더까지 훑으니 폴더 구조를 모를 때 안전한 기본값이다. 이번처럼 파일이 한 폴더에 평평하게 있으면 grep ... output_*처럼 글롭만으로도 충분하다. -o는 긴 난수 한 줄에서 매칭한 부분만 잘라 주므로, 1024글자 전체가 화면을 덮는 걸 막아 준다.
한 가지 함정은 찾은 플래그를 셸에 다시 넘길 때다. WaRP{4ll_7x7_c7rl4?}에는 ?와 {, }가 들어 있는데, 따옴표 없이 그대로 치면 zsh·bash가 ?를 "한 글자 와일드카드"로, {, }를 "중괄호 확장"으로 해석해 전혀 다른 값으로 바뀌어 버린다. 제출 명령에서 플래그를 "WaRP{...}"처럼 따옴표로 감싼 건 셸이 손대지 못하게 막기 위해서다. 플래그에 특수문자가 섞인 문제에서 "분명히 맞는데 오답" 이 나오면 이 인용부호부터 의심하면 된다.
📝 정리
Bronze 2 난이도답게 기법은 단순하지만, "많은 데이터 속에서 한 조각을 찾는다"는 포렌식의 기본기를 그대로 보여 주는 문제다. 세 가지를 남겨 둔다.
데이터가 많을수록 사람 눈을 믿지 말고 도구에 맡긴다. 40만 글자를 훑는 건 사람에게 불가능하지만 grep -r에게는 한순간이다. 로그·메모리 덤프·디스크 이미지처럼 파일이 수백·수천 개로 쏟아지는 상황은 실무에서 흔하고, "무엇을 찾을지"를 패턴으로 정의할 수 있으면 규모 자체는 더 이상 장벽이 아니다. 실제 침해 대응에서도 흐름은 똑같다. 수 기가바이트짜리 메모리 덤프에서 플래그 대신 특정 문자열·URL·악성 지표(IOC)를 찾을 때 grep·strings·yara를 쓰고, "찾을 대상을 정규식 한 줄로 어떻게 표현하느냐"가 곧 분석 속도를 가른다. 이 문제는 그 사고 과정을 가장 작은 규모로 압축해 둔 연습이다.
찾을 패턴이 애매하면 데이터의 '정상'을 먼저 정의한다. 플래그 포맷을 몰랐더라도, 이 더미가 base62 균등 난수라는 걸 통계로 확인해 두면 "난수답지 않은 것"이 곧 단서가 된다. 엔트로피와 문자 집합은 "여기서 뭐가 튀는가"를 수치로 짚어 주는, 포렌식에서 가장 먼저 꺼내는 자다.
가설은 머리로 접지 말고 한 줄 코드로 검증한다. 세로 읽기 가설은 엔트로피만 봐도 가능성이 낮았지만, columns.py 한 번으로 확실히 닫으면 이후 방향을 자신 있게 정할 수 있다. 입문 단계일수록 "아마 아닐 거야"를 실제로 돌려 확인하는 습관이 길게 남는다. 반대로 상위 난이도에서는 이 "정상 정의 → 튀는 값 찾기 → 가설 검증"의 사이클이 더 길고 정교해질 뿐, 뼈대는 변하지 않는다. Bronze 2짜리 grep 한 줄 안에 포렌식의 작업 순서가 통째로 들어 있는 셈이다.


Comments
댓글
댓글을 남기려면 로그인이 필요해요. (네이버 · 구글 계정)
댓글 불러오는 중…